
Recursive Language Models: новый подход к работе с длинным контекстом
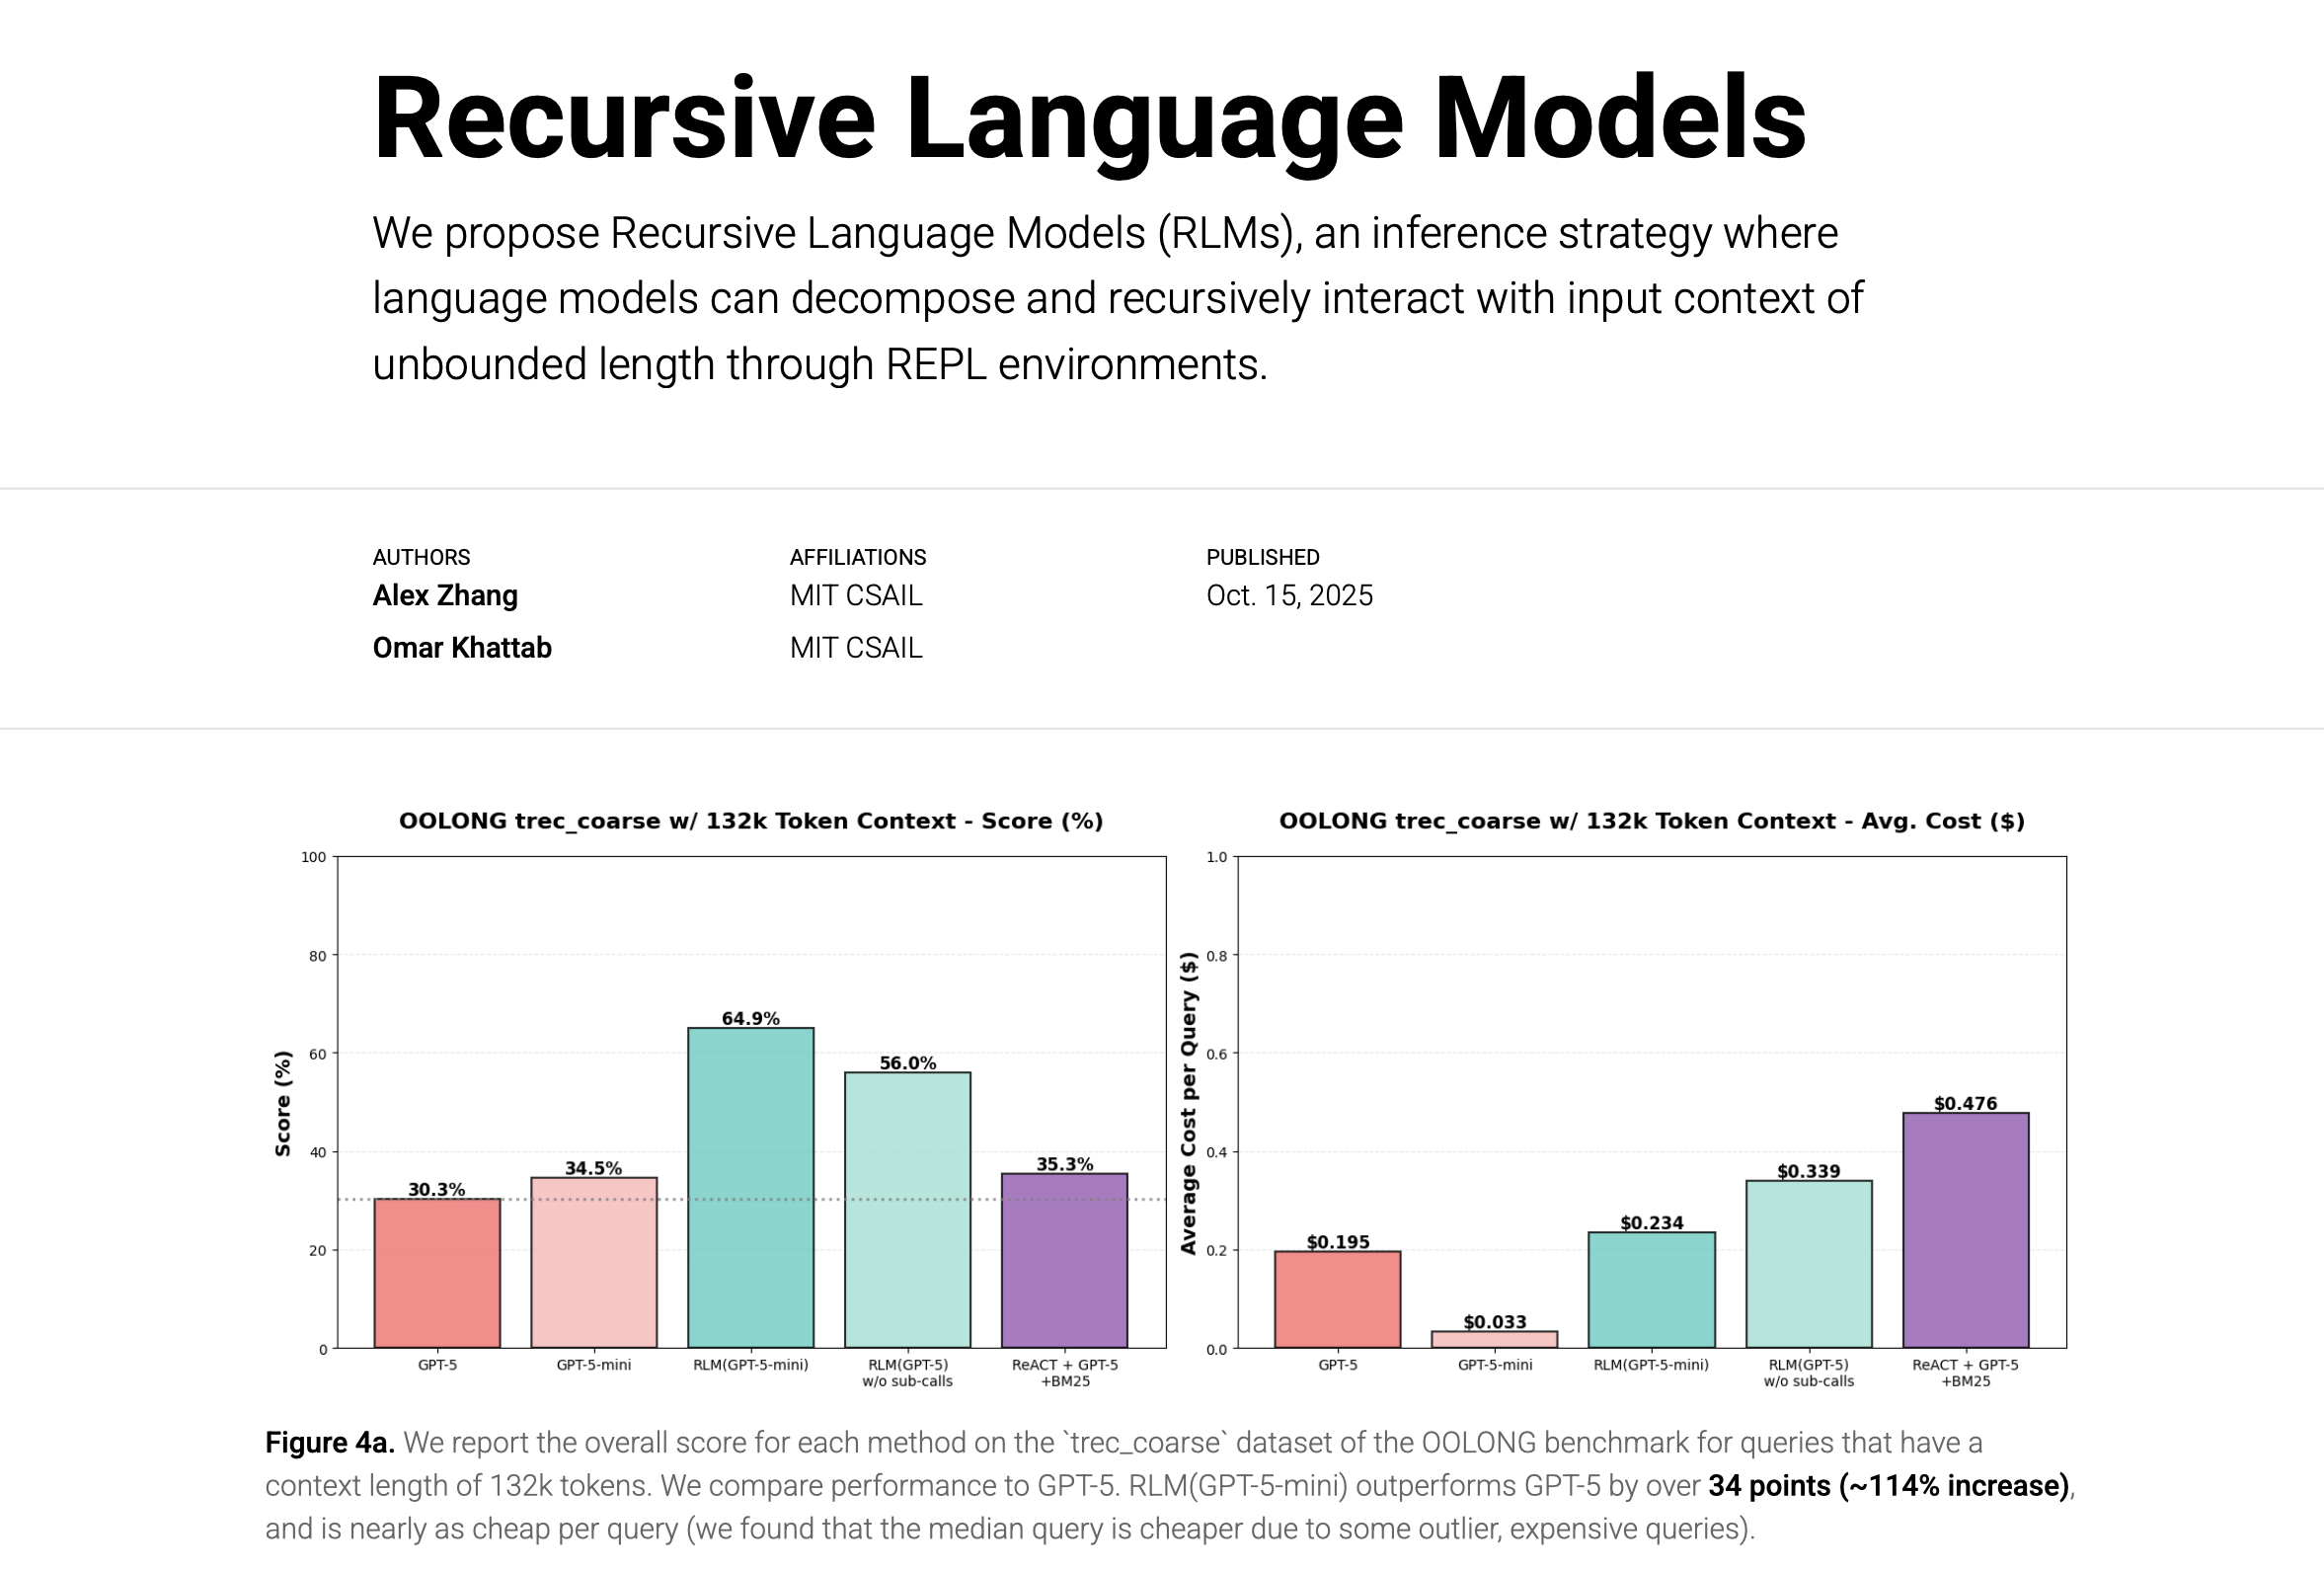
Исследователи предложили Recursive Language Models (RLM) — метод, где языковая модель вызывает сама себя или другие модели для разбора длинного текста.
Традиционные модели страдают от «context rot» — ухудшения качества с ростом длины контекста. RLM решают эту проблему, разбивая контекст на части и обрабатывая их рекурсивно в среде Python REPL.
Такой подход позволяет работать с практически неограниченной длиной контекста и улучшает качество ответов. В тестах RLM с GPT-5-mini дала вдвое больше правильных ответов, чем обычный GPT-5, и при этом была дешевле.
Особенность RLM — они не загружают всю информацию сразу. Модель последовательно изучает части текста, делает подзапросы и строит ответ, избегая потери информации.
Код и подробности доступны на GitHub: rlm. Статья с результатами — на arXiv.
Это простой и перспективный способ масштабирования языковых моделей для сложных задач с большим объемом данных. Изучить проект и попробовать можно по ссылкам.
Поделиться:
Ещё из архива
Все публикации
Интервью с Владимиром Аюевым: графический язык бигтеха, студия SASHA и дизайн-образование
1 месяц назад
Jockey от TwelveLabs: ИИ-агент для семантического поиска по видеоархивам и извлечения метаданных
1 месяц назад
Архитектура винной этикетки: баланс наборного шрифта и каллиграфии в кейсе Winecraft
1 месяц назад
Оптимизация контекста в Claude Code: как работает кэширование промптов и за что мы платим
1 месяц назад
Архитектура памяти для LLM-агентов: от базового SQLite до Graph RAG
1 месяц назад