
Odyssey выпустила Starchild-1 — интерактивную модель мира с синхронной генерацией аудио и видео в реальном времени
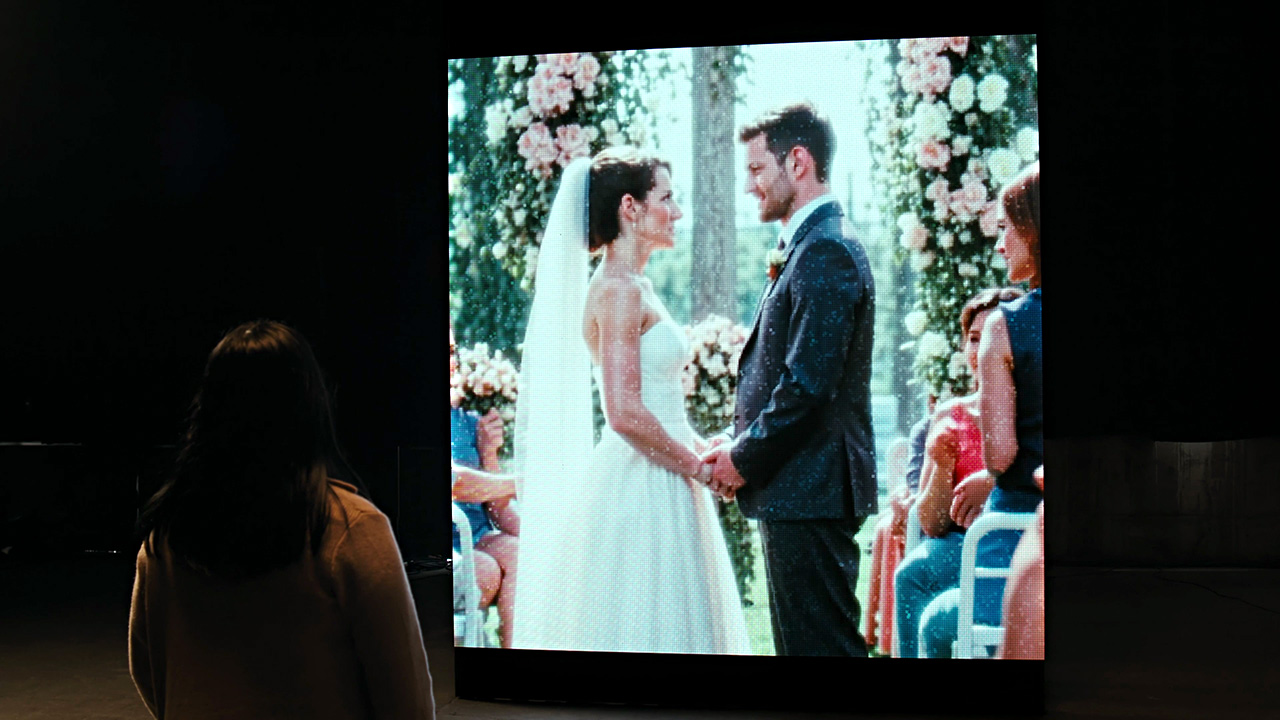
Odyssey перевела генерацию миров в полноценный реалтайм и добавила звук. Их новая модель Starchild-1 умеет авторегрессивно создавать синхронизированное аудио и видео, непрерывно реагируя на потоковый ввод. Если традиционные модели вроде Veo от DeepMind рендерят ролики фиксированной длины в офлайне, здесь среда меняется на лету. Модель учитывает текстовые команды, голос и действия пользователя прямо в процессе генерации.
Синхронизировать картинку и звук в реальном времени сложно из-за разной частоты и плотности информации. На длинной дистанции ошибка в одной модальности быстро ломает весь поток. Для Starchild-1 разработчики собрали пайплайн каузальной дистилляции, который превращает тяжелую foundation-модель в быструю реалтаймовую. В техническом отчете описана асинхронная архитектура KV-cache, специально спроектированная под рассинхрон характеристик аудио и видео при долгом горизонте планирования.
Прошлые алгоритмы Odyssey уже умели выдавать редактируемые сцены при 20 кадрах в секунду, занимая нишу между обычными нейросетями для видео и игровыми движками. Starchild-1 делает следующий шаг к симуляторам физического мира. Окружение, фоновые звуки и физика объектов больше не заперты в жестком сценарии, а развиваются интерактивно в ответ на внешние стимулы.
Поделиться:
Ещё из архива
Все публикации
Интервью с Владимиром Аюевым: графический язык бигтеха, студия SASHA и дизайн-образование
1 месяц назад
Jockey от TwelveLabs: ИИ-агент для семантического поиска по видеоархивам и извлечения метаданных
1 месяц назад
Архитектура винной этикетки: баланс наборного шрифта и каллиграфии в кейсе Winecraft
1 месяц назад
Оптимизация контекста в Claude Code: как работает кэширование промптов и за что мы платим
1 месяц назад
Архитектура памяти для LLM-агентов: от базового SQLite до Graph RAG
1 месяц назад