
Google DeepMind показала Gemini Omni для мультимодального редактирования видео
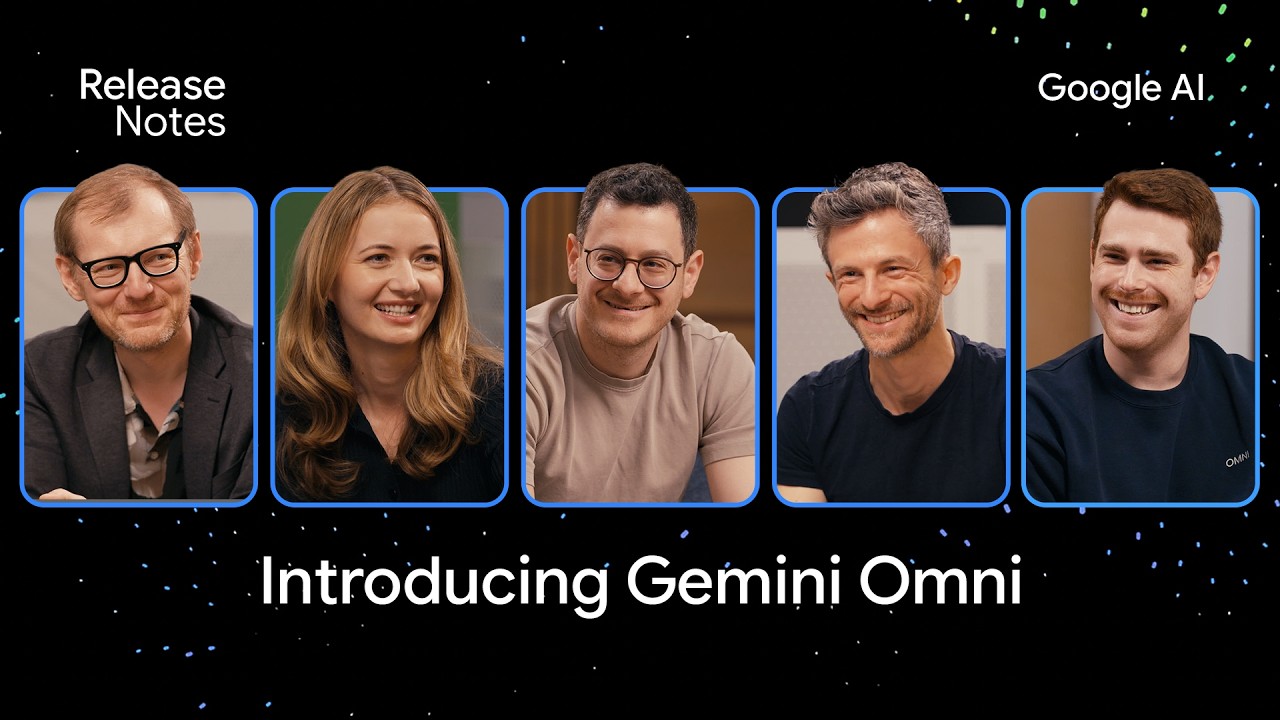
Google DeepMind выпустила Gemini Omni — мультимодальную модель для генерации и редактирования видео. Это архитектурный шаг вперед по сравнению с Veo. Алгоритм одновременно обрабатывает референсы из видео, аудио и изображений. Редактирование реального футажа теперь работает через простые текстовые промпты.
На практике это открывает подход к сложнейшему мета-композу. Задачи по замене объектов или изменению среды в кадре решаются без классической разбивки на слои. Модель бесшовно вписывает генерацию в реальные ролики. Сделать подобные правки стандартными инструментами композа часто технически невозможно из-за высоких затрат времени.
Уровень интеграции нейросетей начинает ломать восприятие контента. При просмотре официального видео с разработчиками быстро ловишь себя на профессиональной деформации. Мозг автоматически начинает оценивать качество липсинка и искать артефакты даже на кадрах с живыми людьми.
Поделиться:
Ещё из архива
Все публикации
Интервью с Владимиром Аюевым: графический язык бигтеха, студия SASHA и дизайн-образование
1 месяц назад
Jockey от TwelveLabs: ИИ-агент для семантического поиска по видеоархивам и извлечения метаданных
1 месяц назад
Архитектура винной этикетки: баланс наборного шрифта и каллиграфии в кейсе Winecraft
1 месяц назад
Оптимизация контекста в Claude Code: как работает кэширование промптов и за что мы платим
1 месяц назад
Архитектура памяти для LLM-агентов: от базового SQLite до Graph RAG
1 месяц назад