
Код пишется быстрее, а релизов меньше. Что реальные метрики говорят о внедрении LLM в разработку
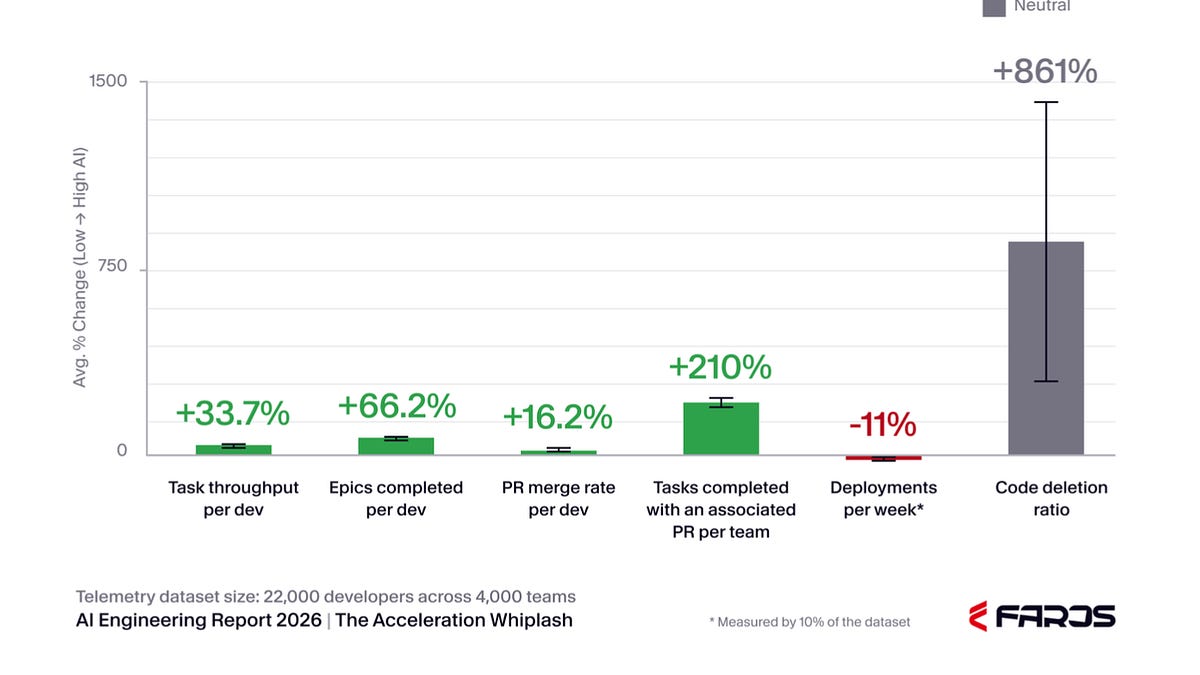
Принято считать, что копайлоты и генераторы кода кратно ускоряют создание продуктов. Компании массово закупают подписки на ИИ, ожидая пропорционального роста производительности. Вопрос в том, что именно мы ускоряем — генерацию символов или доставку реальной ценности пользователю. Аналитическая платформа Faros.ai собрала телеметрию 4000 команд за два года, сравнив периоды до и после активного внедрения нейросетей. Цифры сильно расходятся с обещаниями вендоров.
Индивидуальная продуктивность программистов действительно выросла. Правда, не в десять раз, а примерно на 16%, если оценивать количество создаваемых пулл-реквестов. Но на системном уровне метрики пошли вниз. Частота релизов упала на 11%, а время прохождения задачи от старта до продакшена кратно увеличилось. Разработчики генерируют больше строк кода, но конечный продукт обновляется реже и требует больше времени на стабилизацию.
По сути, индустрия сейчас обменивает качество продукта на локальную скорость набора текста. Используя LLM, команды ускоряют внедрение дефектов в кодовую базу, а процесс их отлова переносится на этап ревью. Искать неочевидные логические ошибки за нейросетью оказалось гораздо дольше, чем писать код с нуля. В итоге очередь пулл-реквестов растет, ревьюеры становятся узким горлышком, а пропускная способность всей системы падает.
Поделиться:
Ещё из архива
Все публикации
Интервью с Владимиром Аюевым: графический язык бигтеха, студия SASHA и дизайн-образование
1 месяц назад
Jockey от TwelveLabs: ИИ-агент для семантического поиска по видеоархивам и извлечения метаданных
1 месяц назад
Архитектура винной этикетки: баланс наборного шрифта и каллиграфии в кейсе Winecraft
1 месяц назад
Оптимизация контекста в Claude Code: как работает кэширование промптов и за что мы платим
1 месяц назад
Архитектура памяти для LLM-агентов: от базового SQLite до Graph RAG
1 месяц назад